AI计算集群(GPU/ASIC)的出货量是驱动光模块和网络带宽需求的根本动力。AI芯片与外部进行数据交换,取决于芯片 本身的网络接口速率以及网络架构;...
2026-09-29 19 人工智能AI行业报告
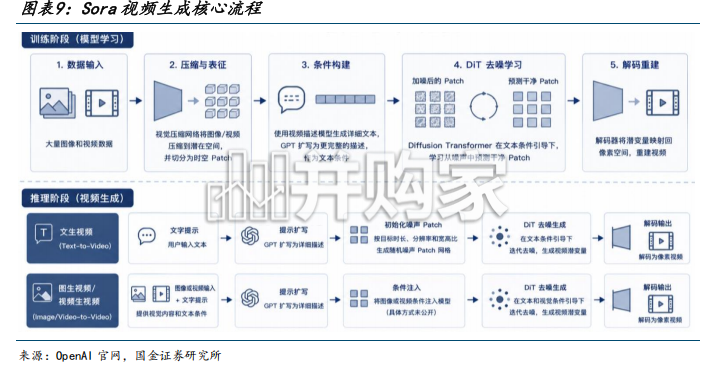
核心流程:1)构建统一视觉表征。训练阶段,Sora 通过视觉压缩网络将图像和视频 从像素空间映射到经过空间和时间压缩的潜在空间,再将潜变量切分为一系列时空 Patch,作为 Transformer 处理的视觉 Token。2)构建文本与视觉条件。训练阶段, OpenAI 利用视频描述模型为训练视频生成更加详细的文字标签,以提高文本与视频 内容的对应关系。生成阶段,GPT 会将用户的简短提示扩展为更完整的描述。3) Diffusion Transformer 迭代去噪。训练阶段,模型接收带噪声的时空 Patch,并在 文本等条件引导下学习预测原始的干净 Patch。文生视频时,模型根据目标视频的时 长、分辨率和宽高比,排列相应规模的随机初始化 Patch 网格,再通过扩散去噪逐步 生成视频潜变量;图生视频和视频生视频则在输入图像或视频的条件下完成动画化、 延展或编辑等任务。4)解码输出视频。生成完成后,视频潜变量通过对应的解码器 映射回像素空间,形成最终视频。
标签: 人工智能AI行业报告
相关文章
AI计算集群(GPU/ASIC)的出货量是驱动光模块和网络带宽需求的根本动力。AI芯片与外部进行数据交换,取决于芯片 本身的网络接口速率以及网络架构;...
2026-09-29 19 人工智能AI行业报告
三代形态不是替代关系,而是叠加关系:中国现有的近300个智算中心项目中,绝大多数仍停留在"卖资源"和"卖算力"...
2026-09-27 36 人工智能AI行业报告
我们认为,全球关于AI产业链的Token计费方式及相关商业模式的兴起,并非行业计费规则的简单迭代,而是对AI技术体系、商业分配机制、产业竞争格局的全链...
2026-09-27 34 人工智能AI行业报告
基于 167 个来自政府官方(52.7%)、服务商白皮书(30.5%)和权威行业媒体(17.3%)的 严格验证案例,以及对信通院 AI Agent 发...
2026-09-25 29 人工智能AI行业报告
生成式人工智能正以空前的速度和深度重塑全球教育生态。在这一进程 中,教师作为教育系统的核心主体,其人工智能素养的高低,直接决定了技 术能否真正服务于育...
2026-09-24 32 人工智能AI行业报告
具身智能作为人工智能领域的一个重要研究方向,专注于智能体通过物理本体 与外界环境的互动来实现智能的理论与技术研究,涵盖环境感知、记忆推理、对话交 互、...
2026-09-24 47 人工智能AI行业报告
最新留言